把 AI-Native SDLC 真的跑起來:實戰反饋
本文目錄
- 先講結果:一個 milestone 從 3 個月以上壓到 1 到 2 週
- 精華版
- Plan:一張卡只寫 Background 和 DoD
- Design:/grill-me 問到收斂,決議回寫 Issue
- Build:Claude Code 寫 code,型別逐字複製
- Test:Stop hook 讓 session 沒驗完不能收工
- Deploy:PR 附證據,人看證據按 merge
- Maintain:Task Card 關卡與 session handoff,還沒有 monitoring
- 下一步:讓 Plan 自己長出來,工程師把時間留給 Design 與決策
- The loop keeps running,人的判斷停在 gate 上
前段時間我寫了一則貼文,整理 Anthropic 的〈The AI-Native SDLC Playbook〉。核心一句話:寫 code 已經不是瓶頸,瓶頸是 code 周圍的一切。build 從幾週壓到幾小時之後,plan、review、deploy 還跑在人的速度上,結果就是 review queue 越積越長,或者 code 在沒人細看的情況下出貨。
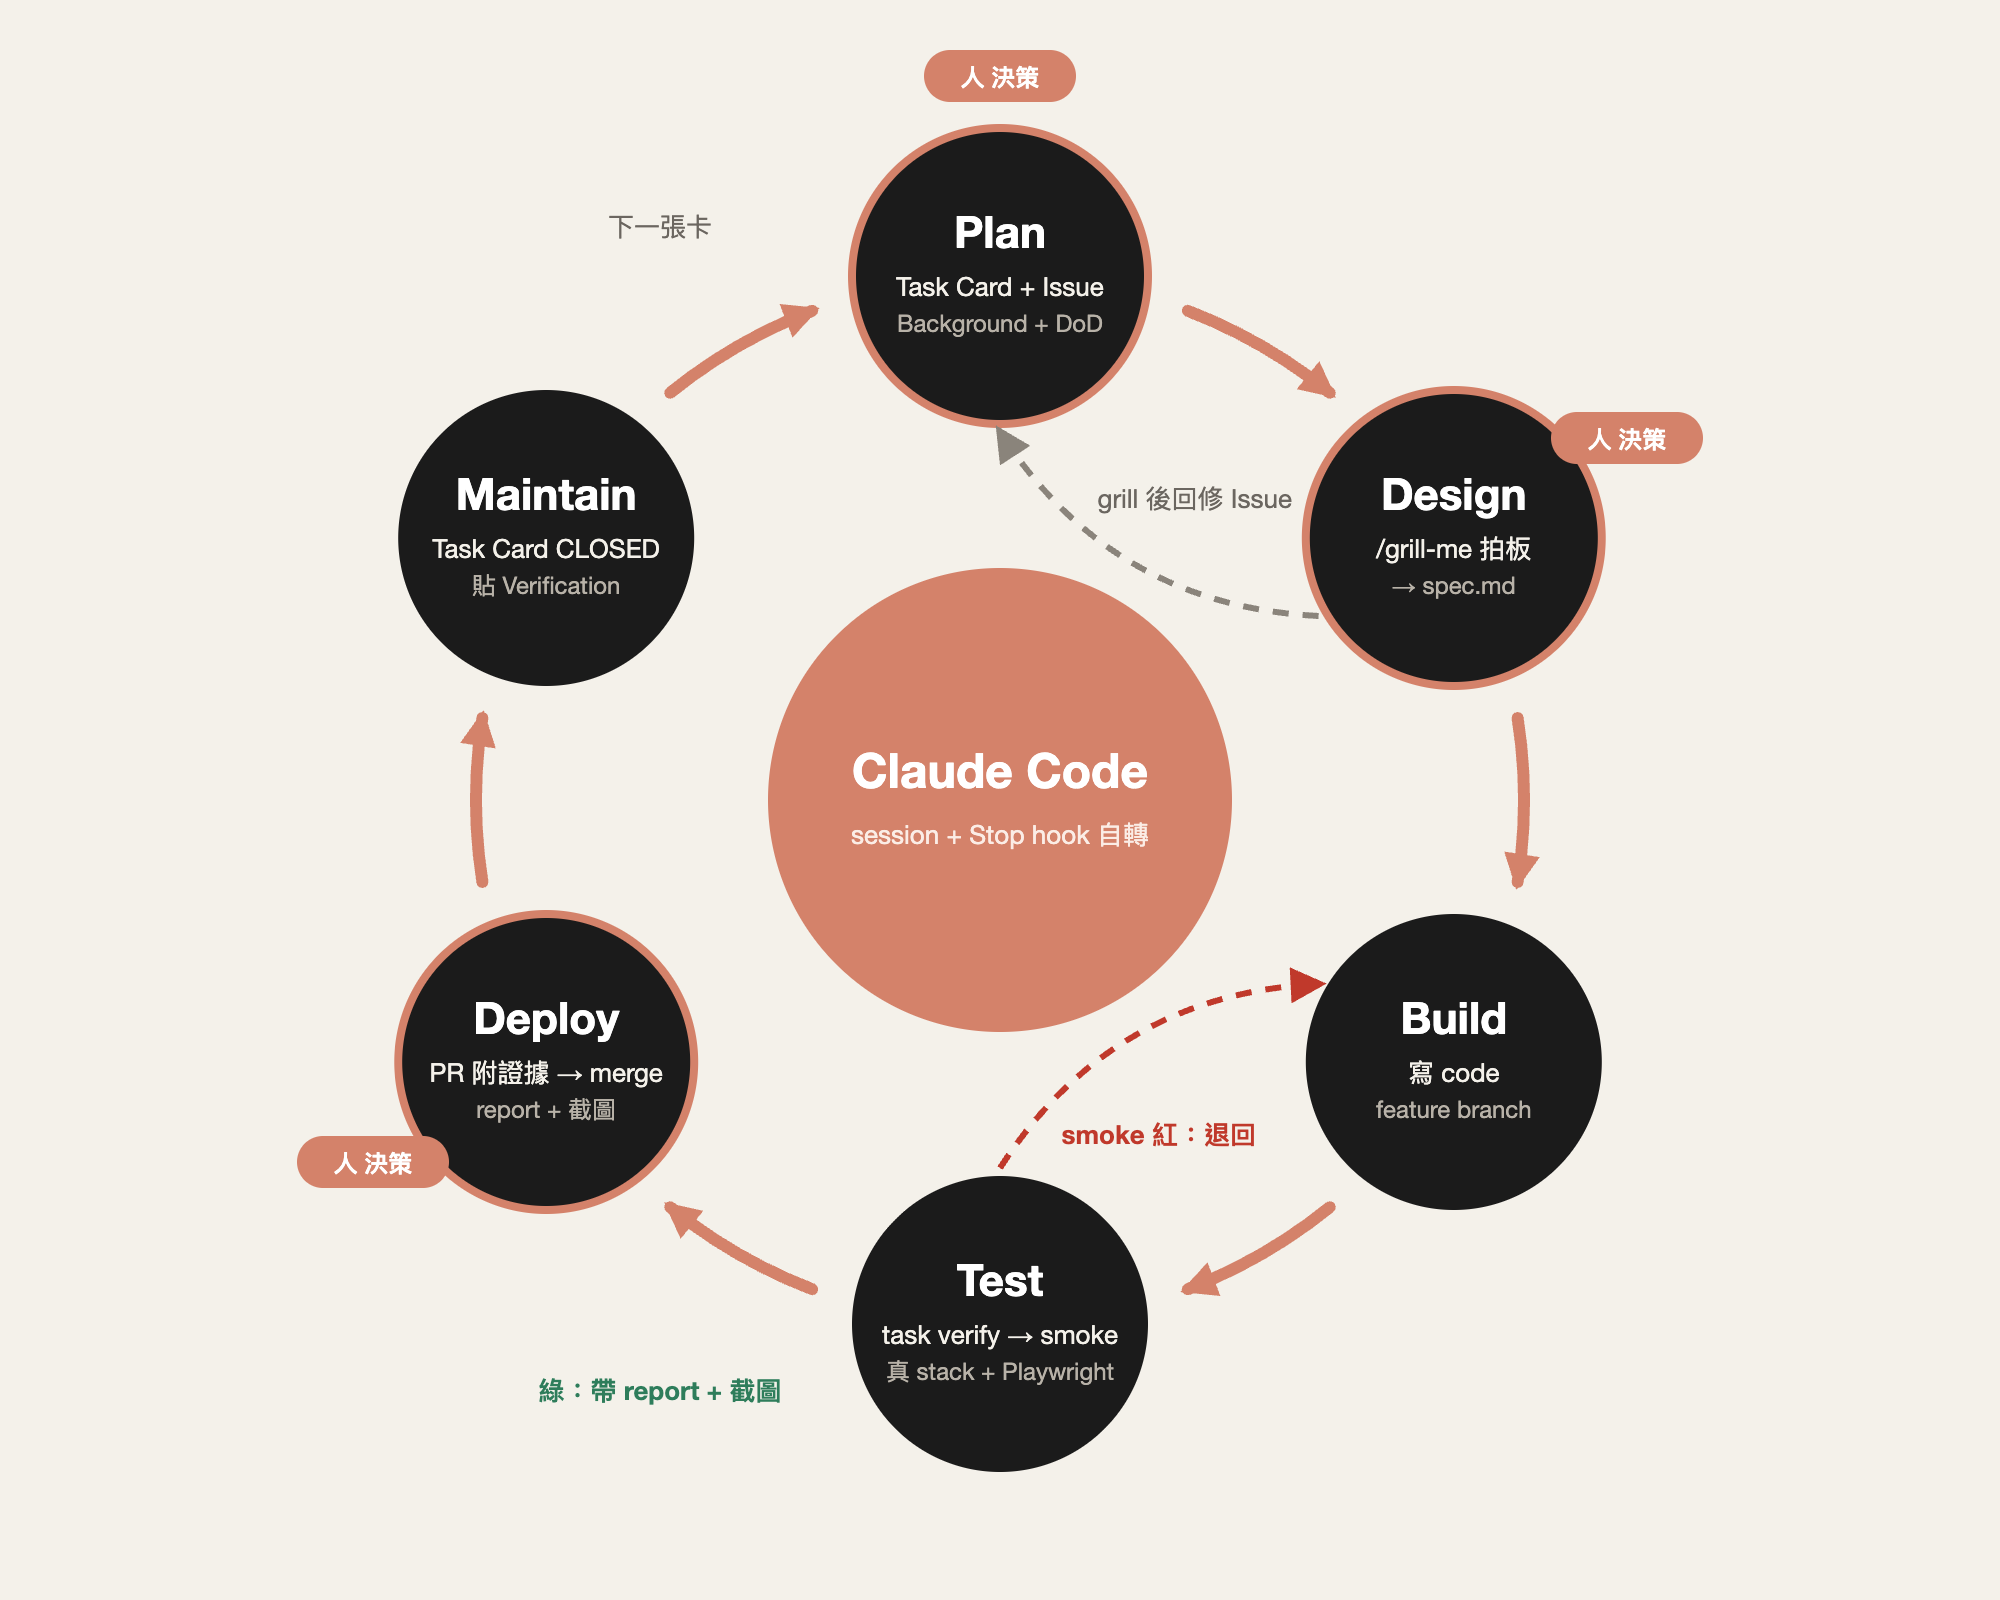
貼文寫完,剩下的問題是這套在真的專案裡到底長什麼樣。我們在一個 Agent 專案(Backend + Frontend)的前端部分,拿第一個 milestone 的八張卡當試驗,每一張卡都走一遍 playbook 的六步。這篇是跑完之後的記錄,圍著下面這張圖講,每個節點一段,最後講我接下來想怎麼改這個 loop。
讀完精華版(2 分鐘),你會理解:
- 一個 milestone 的開發期從 3 個月以上壓到 1 到 2 週,時間之外還換到了什麼
- Playbook 裡的 intent.md / spec.md / plan.md,對應到我們手上就是 Notion 卡、GitHub Issue、grill 出來的 spec,每一站留下什麼檔案
- 為什麼 Test 是這個 loop 的心臟:差別不在有沒有 Playwright,而在誰觸發、什麼時候擋
- Stop hook 四個判斷的 shell 邏輯,以及它產出的 report 與截圖怎麼一路帶到 PR 和 Task Card
- Plan 為什麼可以變成入口:Monitor、QA、Sales、Meeting 的訊號都能被起草成卡,工程師從寫卡退到 triage 和 Design
這不是 Claude Code 教學,也不是 Playwright 教學。這是一份「六步 loop 落到一個真實 repo 時,每一步的 artifact 與觸發點是什麼」的對照表。
先講結果:一個 milestone 從 3 個月以上壓到 1 到 2 週
過去同樣規模的一個 milestone,開發期是 3 個月以上。從需求到實作再到使用者回饋的一圈,常常超過 1 個月才轉一次,等回饋回來,當初為什麼要做這件事的脈絡都已經淡了。這次整個 milestone 走完 loop,花了 1 到 2 週。
時間只是最容易量的那一半。另一半是 loop 轉得快之後,兩件以前互相拉扯的事同時變好了。一圈從一個月縮到幾天,同一段時間內可以多改幾輪,錯的方向在第二週就被回饋修掉,做出來的東西更貼近使用者要的。同時系統也更穩,因為每一張卡結束前都被強制跑過一次完整流程的 smoke,證據留在 PR 與卡片上。以前是功能做完再排時間補測,現在沒驗完根本收不了工。
快、穩、貼近需求,通常三個只能挑兩個。這篇想講的是讓三件事同時成立的條件:loop 每一站留下什麼、由誰觸發下一站。如果你的團隊也用上了 agentic coding,但感覺快的只有寫 code 那一段,後面六節可以直接對照著看。
精華版
| Stage | Playbook 的 artifact | 我們的 artifact | 誰出手 |
|---|---|---|---|
| Plan | intent.md | Notion Task Card(Background + DoD)+ GitHub Issue | 人 |
| Design | spec.md | /grill-me 問到收斂 → docs/specs/*.md,決議回寫 Issue | 人拍板 |
| Build | plan.md → diff | feature branch,型別從後端 repo 逐字複製 | Claude Code |
| Test | agent 自己的 feedback loop | task verify + Stop hook 強制 task smoke,產出 report.md + 截圖 | hook |
| Deploy | PR review,人看 intent 與 risk | PR 貼 smoke report + 截圖,人看證據按 merge | 人 |
| Maintain | monitoring → 新 intent | Task Card CLOSED,貼 Verification,寫 _tem/mem.md 給下個 session | hook + 人 |
- 人只在三站出手:Plan 寫卡、Design 拍板、Deploy 按 merge。其餘由 Claude Code session 與 Stop hook 自轉。
- Test 是心臟:Stop hook 讓 session 沒 smoke 綠不能結束,smoke 產出的 report 與截圖就是 PR 和 Task Card 的內容,同一組證據從 Test 一路帶到 Maintain。
- Plan → Design 本身是小 loop:grill 問出來的決策會回頭改 Issue,所以 Design 節點有一條虛線指回 Plan。
- Plan 的下一步是變成入口:Task Card 格式小且固定,所以 Monitor、QA、Sales、Meeting 的訊號都能被 agent 起草成卡,人從寫卡退到 triage,工程師的時間集中到 Design 與決策。
以下是完整版,按需取用。
Plan:一張卡只寫 Background 和 DoD
Playbook 的 Plan 階段產出 intent.md,一份 version-controlled 的意圖文件,不再經過 backlog、user story、refinement meeting 層層轉手。我們的版本是 Notion Task Card 加一張 GitHub Issue。
小卡刻意只寫兩段。Background 回答三件事:現況是什麼、為什麼要動、要做什麼。DoD(Definition of Done,完成的定義)三條左右,每一條都要可以驗證。一張卡的量大約等於一個 PR。完整的驗收細節放 Issue,卡片本身保持一眼看完。
這一站目前是人的工作。寫卡的人要把「想要的結果」翻成「怎麼證明做到了」。格式刻意選得很小,這個選擇在文章最後一段會再回來。
Design:/grill-me 問到收斂,決議回寫 Issue
Playbook 把 requirements 與 design 壓成一個 session,讓 skills 作為 constraints 套在 spec 上,有疑慮直接 flag 給 product owner。
我們用的是 grilling skill:/grill-me 針對這張卡一題一題問設計決策,每題附建議答案,問到沒有新問題為止。
產出寫進 docs/specs/ 下的一份 spec.md。被 grill 出來的決議會回寫到 Issue,所以圖上 Design 有一條灰虛線指回 Plan:拍板之後 Issue 長得跟一開始不一樣,是正常的。
人在這裡拍板。grill 的價值在於它逼你回答,答不出來的題目通常就是 domain knowhow 的缺口。答不出來就先去補,不要讓 AI 替你猜。
Build:Claude Code 寫 code,型別逐字複製
這一站最無聊,也應該最無聊。Claude Code 在 feature branch 上寫 code。唯一一條硬規則是契約不手寫:TypeScript 型別從後端 repo 逐字複製過來,型別對不上就改 UI。
這條規則讓 Build 不用靠人 review 型別正確性。後端一改契約,前端 typecheck 就紅,問題在 Test 站就被擋下來,輪不到 Deploy 站的人眼。
Test:Stop hook 讓 session 沒驗完不能收工
Playbook 對 Test 的說法是給 agent 一個 feedback loop(tests、build、screenshot diff),讓它在人看到之前先驗證自己的產出。我們有兩層。
第一層 task verify,等於 typecheck 加 vitest,離線跑,CI 也跑這個。第二層 task smoke:用 playwright-core 開系統的 Chrome,對真的 dev server 加一個假的後端資料來源走完這個 milestone 的整條使用流程,共 11 站,每站截一張圖放到 _tem/smoke/<ts>/,寫一份 report.md。
smoke 只驗結構性事實。舉幾站 report 裡的斷言:
- landing:scenario 選項數量等於
GET /api/config回傳的數量 - resume-list:列表筆數等於後端 standalone assessments 的筆數(53 vs 53),每一列都有狀態 badge
- upload:選中的資料來源卡片
aria-pressed、另一張取消選取、header 出現對應的 badge,reload 之後 badge 與總覽卡片都還在 - first-draft:draft card 的分組數等於 server 決策回傳的分組數,不比對 LLM 寫的說明文字
- confirm:
session.status是 confirmed,左側 rail 的五個步驟狀態跟 server 的 jobPlan 一字不差
每一條都在問「畫面上的東西跟 server 說的一致嗎」,而不是「畫面好不好看」或「LLM 說得對不對」。這讓 smoke 可以離線跑、跑得穩,加 --llm 才會讓 first-draft、hitl-turn、confirm 三站走真的 LLM。
差別在觸發點。smoke 由 Claude Code 的 Stop hook 在 session 要結束時強制跑,不靠人記得。hook 的邏輯就四個判斷:
# Stop hook:session 不能帶著沒驗過的 UI 變更結束

# 1. src/ 沒改 → 放行
changed=$( { git diff --name-only HEAD -- src; git ls-files --others --exclude-standard src; } | sort -u)
[ -z "$changed" ] && exit 0

# 2. 同一份 diff 已經綠過 → 放行
fingerprint=$( { git diff HEAD -- src; ... } | shasum | cut -c1-40)
marker=_tem/smoke/.last-green
[ -f "$marker" ] && [ "$(cat "$marker")" = "$fingerprint" ] && exit 0

# 3. server 沒起 → 擋,叫人去起,hook 自己不起 server
for port in 5173 4000; do
  lsof -tiTCP:$port -sTCP:LISTEN >/dev/null || { echo "...start the stack..." >&2; exit 2; }
done

# 4. smoke 紅 → exit 2,把失敗站塞回 session
out=$(task smoke 2>&1) || { printf '%s\n' "$out" | grep '^✗' >&2; exit 2; }

printf '%s' "$fingerprint" > "$marker"
echo "smoke green — evidence for the PR / Notion card: $report"
exit 2 在 Claude Code 的 Stop hook 裡代表「不准停」,stderr 的內容會回到 session。所以 smoke 紅的時候,Claude Code 看到的是哪幾站失敗,然後繼續改。圖上 Test 指回 Build 那條紅虛線就是這個。綠的時候 hook 印出 report 路徑,這份 report 加截圖就是下一站要用的東西。
還有一個細節:hook 會檢查 stop_hook_active,如果上一次已經因為 hook 被擋過,這次就直接放行,避免無限循環。這是 Claude Code 本身的約定。
CI 只跑 typecheck 加 test,沒有瀏覽器。smoke 是 local 的 gate,開發者的機器上有 Chrome、有真的 server,這是它能跑真流程的原因。
Deploy:PR 附證據,人看證據按 merge
Playbook 的 Deploy 是讓 Claude 同時給 review 也回 review comment,人專注在 intent 與 risk。我們的做法簡單很多:PR 貼上 smoke 的 report 和截圖,截圖放在一個 orphan branch evidence 上,人看證據按 merge。
人在這裡不需要逐行看 code。要看的是:這張卡的 DoD 有沒有被 report 裡的 ✓ 覆蓋,截圖長得對不對。review 的單位從 diff 變成證據。
Maintain:Task Card 關卡與 session handoff,還沒有 monitoring
Playbook 的 Maintain 是閉環:monitoring 偵測到異常,agent 自動診斷,寫成新的 intent.md 重新進入 pipeline。
我們目前做到的是關卡加 handoff。Task Card 最上方放 PR 連結和 merged 日期,加一段 ## Verification 貼真實 log 與同一組截圖,DoD 打勾,卡片 CLOSED。session 結束前寫一份 _tem/mem.md 給下一個 session 接手。然後開下一張卡,回到 Plan。
從 Test 站產出的那份證據,先進 PR,再進 Task Card,中間沒有重新產生過。這是我覺得整套裡最值得留下的一件事:每張卡從 Issue 到 Notion 一路可追,用的是同一份東西。
目前沒有 monitoring,Maintain → Plan 那個箭頭現在是人推的。這也是我接下來想改的地方。
下一步:讓 Plan 自己長出來,工程師把時間留給 Design 與決策
回頭看 Plan 那一站。小卡只有 Background 加 DoD,一開始只是為了讓卡片一眼看完。跑完八張之後我發現這個格式另有回報:它小到任何來源的訊號都能被轉成它。
現在開卡的是工程師。但一個新創團隊裡,會產生「該做什麼」訊號的人遠不只工程師:
| 入口 | 原始訊號 | 現況 |
|---|---|---|
| Monitor | smoke report 紅、LLM 輸出結構不一致 | 訊號已有,排程化就能接 |
| QA | 使用者視角的 bug report、驗收回饋 | 方向 |
| Sales | 客戶對話帶回的期待、市場的直接反饋 | 方向 |
| Meeting | 會議記錄裡的決議與待辦 | 方向 |
四條入口可以是同一個形狀:訊號進來,agent 起草成一張 Background 加 DoD 的卡,人 triage 決定開不開。人在 Plan 站的工作從「寫卡」退到「看卡」。
Monitor 這條是最接近的。smoke 已經會跑,排程化(例如 GitHub Actions schedule)之後定時對測試環境跑一輪帶 --llm 的 smoke,紅了讓 Claude 讀 report 診斷、起草一張卡。用真實資料跑的時候就抓到過一次:模型的說明文字說有 8 組,結構上只有 7 組。這種錯誤 UI 層看不出來,它是 LLM 輸出品質的訊號,現在只有人跑真資料才看得到。把這類「結構與文字不一致」納入斷言,它就會變成 Monitor 入口的一個來源。做到這步,Maintain → Plan 的箭頭才是自動的。
其他三條還是方向,但形狀一樣。Sales 帶回的客戶期待、QA 從使用者視角看到的問題、會議上拍板的待辦,都能被起草成卡等人 triage。對新創來說這件事的意義是,市場反饋進到工程 pipeline 的路徑,不用再經過「找工程師開會、工程師有空再寫卡」這一段排隊。
再往前一步:卡有了 Background 和 DoD,agent 就能依 DoD 條數與影響範圍判斷難易度。小而急的 fix,例如文案錯字、一個狀態欄位沒對上,可以不等工程師 triage 與拍板直接做掉。但 Stop hook 與 PR 證據不跳:smoke 照樣強制跑,PR 照樣附 report 和截圖,人在 Deploy 站看證據按 merge。省掉的是排隊時間,人看一眼這步保留。這跟 playbook 的立場一致,production 放行一定有 named 的人簽核。
這樣調整之後,工程師的時間會集中到 Design。grill 出來那些答不出來的題目、需要 domain knowhow 才能拍板的決策,才是人該花時間的地方。
The loop keeps running,人的判斷停在 gate 上
Playbook 文末說:The loop keeps running. Human judgement stays above it.
跑完八張卡,我對這句話的理解是:人的判斷停在 gate 上。現在是三個,卡該不該開、spec 該不該過、證據夠不夠 merge。下一步是把第一個交給 agent 起草,人只 triage,讓判斷力集中在 Design 與 Deploy。這套的價值在於每張卡留下同一組證據,從 Issue 到 Notion 一路可追,而且任何人的訊號都能變成下一張卡。AI 寫得快只是副產品。
相關文章
- Claude Code 五個組件的觸發邏輯,以及為什麼 Hooks 是最被低估的那一個:Stop hook 為什麼能擋 session,hook 與 skill 的差別在哪
- 一半的 code 是 AI 寫的之後,品質靠什麼守:DeepSeek Harness 的工程門檻:另一個把品質門檻做成機器可驗證的樣本
- Task Continuity,不是 Personal Memory:Claude Code 的 Session 設計:
_tem/mem.md這種 session handoff 背後的設計思路